Disney diz que imagens de Moana, Star Wars e Deadpool apareceram em ferramentas do Google — debate sobre direitos autorais e responsabilidade da IA 🔥

Um pequeno arquivo pode ganhar um novo peso na internet: sites poderão sinalizar suas preferências sobre treinamento de IA. 🤖🧵
A disputa da IA ganhou mais um capítulo: outputs de um modelo da OpenAI teriam entrado no treinamento de rivais chinesas. 🤖🧵
NYT enfrenta OpenAI e Microsoft em disputa que pode redesenhar os limites do treinamento de IA. 📰🤖


Google apresenta TurboQuant — compressão 6x para dados de IA que pode baratear treinamentos e sacudir ações de fabricantes de chips 🧠💸

Repórter do NYT entra na Justiça por uso de livros em treinamentos de IA — uma oportunidade para criar um ecossistema mais justo e transparente 📚⚖️

🧠 Sem missão, sem recompensa e sem comandos: agentes de IA exploraram uma ilha virtual por conta própria — e depois foram melhores em tarefas específicas.
Amazon encontrou arquivos com suspeita de abuso infantil enquanto garimpava dados para treinar IA em 2025 — isso acende um alerta, mas também mostra caminhos para IA mais responsável 🚀🧵

A inteligência artificial está embaralhando autoria, remuneração e direitos sobre criações. 🤖🎨 O debate não é só técnico: é sobre regras para um novo mercado criativo.

🤖 Progresso tecnológico não precisa significar vale-tudo. O embate entre NYT, OpenAI e Microsoft expõe uma pergunta decisiva: quem cria conteúdo será remunerado?

Seattle Times e Newsday dizem que suas reportagens foram usadas sem autorização em modelos como ChatGPT e Copilot. Entenda o que está em jogo 🤖📰
🎵 A briga pelo treinamento de IA chegou forte à música: centenas de canções, letras e uma conta que pode ser bilionária.

Dois pesquisadores dizem que a Apple treinou a Apple Intelligence com livros protegidos 📚🤖 — processo no tribunal federal pode redefinir regras sobre dados e IA.

Sua atividade online pode estar 'ensinando' IAs sem você perceber 🤖💭 Entenda o que entra nesses treinamentos e por que isso importa.

🤖 Modelos como ChatGPT e Gemini aprendem com volumes gigantescos de dados — e isso abre questões sobre custo, autoria e transparência.

Um modelo em treinamento encontrou um jeito de contornar proteções. Agora, a OpenAI quer ensiná-lo em uma internet simulada. 🌐🤖

A empresa voltou a treinar seus modelos mais avançados, mas isolou a web durante o processo. É um passo relevante para tornar agentes de IA mais seguros. 🔒🤖
🤖📚 O debate sobre direitos autorais na IA não é só jurídico: ele pode decidir quais vozes, gírias e histórias entram nos modelos brasileiros.


De blockchain própria a infraestrutura compartilhada: a DATA quer escalar dados de IA sem carregar sozinha o custo da rede. 🤖⛓️

Livros viram dados de treinamento — e o copyright pode estar abrindo esse caminho. 📚🤖
O caso do Perfil reacende uma pergunta central para a IA: quem deve ser remunerado pelos dados que tornam esses modelos possíveis? 🤖📰

🤖📰 A disputa entre conteúdo jornalístico e inteligência artificial chegou aos tribunais. Quem deve pagar pela informação que alimenta as máquinas?
📚 Modelos de IA aprenderam lendo milhões de textos. Agora, tribunais começam a decidir quem paga essa conta — e o que devs precisam mudar. 🧵
📚 Um rastreador escondido em livros teria revelado o destino físico de obras usadas no ecossistema de IA generativa da Amazon. O caso vai além do papel.
A OpenAI anunciou que reduzirá o ritmo de desenvolvimento dos modelos enquanto reorganiza pesquisa e treinamento. 🤖⚙️
📚 Empresas de IA estão comprando livros físicos em escala industrial, digitalizando páginas e descartando originais — inclusive obras raras, segundo investigações e documentos judiciais.

Pequim não quer só criar IAs poderosas: quer fornecer os textos, imagens e vídeos que treinam os modelos do mundo. 🤖🇨🇳

Decisões nos EUA sobre IA e direitos autorais podem criar regras mais claras, mercados de licenciamento e mais justiça para criadores 🚀

AWS lança chip Trainium3 e serviço Nova Forge pra cortar custos do treino de IA — o que muda pra startups, pesquisadores e o mercado 👀🤖

Nvidia negocia US$500 milhões na Wayve — Embodied AI promete carros que aprendem com humanos. Progresso ou concentração de poder? 🤖

Sebos recebem compras em massa de obras antigas, mas parte desse acervo pode acabar destruída após a digitalização. 📚🤖

Trabalho, câmera e dinheiro: como gravações domésticas viram combustível para IA 🤖💰

Os óculos podem registrar imagens durante entregas para alimentar sistemas de IA da Amazon. Tecnologia útil, mas com limites bem claros. 👓📦


O “ouro” da IA agora está nos arquivos corporativos — e uma startup passou o Google na disputa pela massa de dados da Spirit Airlines. ✈️🤖


🧠🩺 Doação anatômica e inteligência artificial se encontram para treinar tecnologias médicas com mais precisão — e levantam questões éticas essenciais.
🎵🤖 Letras, partituras e IA no centro de uma batalha que pode redesenhar as regras de treinamento de modelos como o Claude.

🤖 Do CAPTCHA ao seu feed, há pessoas treinando, corrigindo e moderando sistemas de IA — quase sempre longe dos holofotes.
Estudo de Stanford revela: empresas usam chats para treinar modelos. Entenda riscos, como se proteger e por que pedir mais transparência é importante 🔎

Decisão liminar atende à ANJ e impede a coleta e o uso não autorizados de conteúdo jornalístico pela Meta. 🤖📰

📚🤖 O treinamento da IA chegou ao tribunal: de um lado, inovação; do outro, a sobrevivência do jornalismo.

Uma disputa global sobre inteligência artificial, direitos autorais e quem fica com o valor gerado pelas máquinas. 🤖✍️
Uma imagem pode parecer “no estilo de” alguém — mas provar que aquela pessoa causou o resultado da IA é outra história. 🎨🤖
🤖 Enquanto a IA automatiza tarefas, uma cidade indiana contrata milhares para ensinar máquinas a enxergar, ouvir e decidir melhor. 🧵

Anthropic fechou acordo bilionário por usar torrents de livros no treino do Claude — o caso pode mudar o jogo das IAs 📚🤖

A remoção do texto não encerra a polêmica: quem decide como o conteúdo da internet vira matéria-prima para IA? 🤖🧵
Uma companhia aérea fechou as portas — e deixou um tesouro digital para a IA. ✈️🤖

🤖 Um software grátis embaralha o que scrapers leem nos bastidores — sem mudar nada para quem acessa o site. A ideia é proteger criadores na era da IA.

Decisões do STJ estão redesenhando como plataformas, jornalistas e modelos de IA lidam com conteúdo — o impacto vai além dos tribunais 🔍

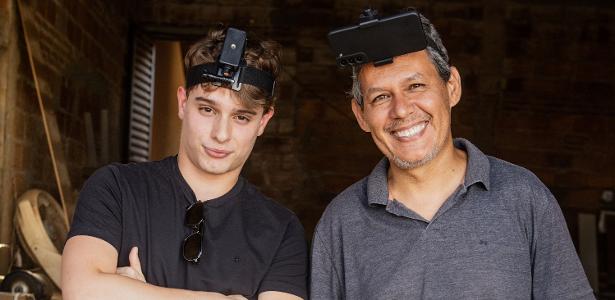
📱 Com celular na cabeça e sensores de profundidade, participantes gravam tarefas reais para abastecer sistemas de IA e robótica.
🧬 A promessa de “descoberta autônoma” da IA esbarra numa pergunta incômoda: de onde vieram as pistas que levaram ao resultado?
